『プリンシプル オブ プログラミング 3年目までに身につけたい 一生役立つ101の原理原則』を読んでいて、「インターフェースと実装の分離」という考え方が紹介されていました。
要点としては、
- 利用者は、内部でどのように実現されているかを知る必要がない
- 「どう使うか」と「どう実現するか」を分離する
- 実装を変更しても、利用側への影響を小さくできる
というものです。
この章を読んでいて、ふとAgent Skillsの構成も同じ考え方で設計できるのではないかと思いました。
Agent Skillsについての記事はこちら。
Agent Skillsでは、SKILL.mdだけにすべてを書き込むのではなく、必要に応じてreferences、scripts、テンプレートなどへ情報を分離できます。
この構成を「インターフェースと実装の分離」という視点で見ると、Agent Skillsの設計がかなり整理しやすくなります。
Agent Skillsにおける「インターフェース」とは何か
例えば、詳細設計書を作成するSkillを考えてみます。
SKILL.mdには次のような内容を定義します。
# 詳細設計書作成Skill

## Input

- 対象機能
- 要件
- 既存仕様

## Process

1. 設計ルールを確認する
2. 入力された仕様を分析する
3. テンプレートに従って詳細設計書を作成する
4. レビュー基準に従ってセルフレビューする

## Output

Markdown形式の詳細設計書を出力する
一方で、具体的な情報は別ファイルに分離します。
detail-design/
├── SKILL.md
├── references/
│   ├── design-rules.md
│   └── review-rules.md
├── templates/
│   └── detail-design.md
└── scripts/
    └── analyze.py
ここで重要なのは、SKILL.mdには「何をするか」は書かれていますが、「具体的にどのようなルールで設計するか」までは書かれていないことです。
設計ルールはreferencesにあります。
出力形式はtemplatesにあります。
必要であれば具体的な処理はscriptsにあります。
つまり、利用するAgentから見ると、
入力を受け取り、設計ルールを参照して、決められた形式で詳細設計書を作成する
という使い方だけ理解すればよくなります。
内部でどのような設計ルールが使われているかまで、最初から知る必要はありません。
これはまさに、プログラミングにおける「インターフェースと実装の分離」に近い構造だと思います。
SKILL.mdは単純なインターフェースではない
ただし、SKILL.md = インターフェースと完全に一致するわけではありません。
一般的なプログラミングのインターフェースでは、主に外部から利用するための契約を定義します。
一方、SKILL.mdでは、
- いつこのSkillを使用するか
- どのような入力を受け取るか
- どの資料を参照するか
- どのような順序で処理するか
- 何を出力するか
といった、処理の流れまで記述します。
そのため、個人的にはSKILL.mdは単純なインターフェースというより、
契約 + オーケストレーション
に近い存在だと考えています。
Agentに対して、
「このSkillを使うときは、この順序で必要な情報を参照し、最終的にこの形式で出力してください」
という全体の振る舞いを定義する場所です。
具体的な実装を外部に出す
この考え方で重要なのが、SKILL.mdに具体的な実装を書きすぎないことです。
例えば、影響調査Skillを作るとします。
SKILL.mdに次のように書いてしまったとします。
1. grepで変数名を検索する
2. findstrでCALL文を検索する
3. xxx.batを確認する
4. 結果をCSVに出力する
これでは、「影響調査をする」というSkillそのものが、Windowsバッチやgrep、findstrといった具体的な実装に依存してしまいます。
もし将来的にJavaの影響調査をしたくなった場合、このSkillはそのまま利用できません。
そこで、SKILL.md側ではもう少し抽象化します。
## Process

1. 変更対象を特定する
2. 参照関係を調査する
3. 影響範囲を分析する
4. 調査結果をレポートする
具体的な解析方法は別ファイルに出します。
references/
├── batch-analysis-rules.md
├── java-analysis-rules.md
└── typescript-analysis-rules.md
必要であれば、実際の解析処理も分離します。
scripts/
├── analyze-batch.ps1
├── analyze-java.py
└── analyze-typescript.ts
こうすると、Skillの本質は変わりません。
Skillが行うことは一貫して、
変更対象を特定し、依存関係を調査し、影響範囲を分析する
ことです。
Windowsバッチであればgrepやfindstrを使うかもしれません。
JavaであればAST解析を使うかもしれません。
TypeScriptであればTypeScript Compiler APIを使うかもしれません。
しかし、それはSkillを利用する側が意識する必要のない「実装」です。
実装を差し替えられるSkillになる
ここまで分離すると、Skillの構造を大きく変えずに、実際の振る舞いを変更できるようになります。
例えば、詳細設計書作成Skillであれば、SKILL.mdはそのままにして、
references/design-rules.md
だけ変更できます。
Windowsバッチ向けの設計ルールからJava向けの設計ルールへ変更しても、
設計ルールを確認する
↓
仕様を分析する
↓
テンプレートに従って出力する
↓
レビューする
というSkill全体の流れは変わりません。
テンプレートについても同じです。
会社Aの設計書フォーマットから会社Bのフォーマットへ変更する場合でも、テンプレートだけ差し替えればよくなります。
つまり、
SKILL.md
        ↓
何をするか

references/
        ↓
どのルールで判断するか

scripts/
        ↓
どのように処理するか

templates/
        ↓
どのような形式で返すか
という責務分離ができます。
これは、かなりプログラミングの設計に近い考え方です。
段階的開示との相性がいい
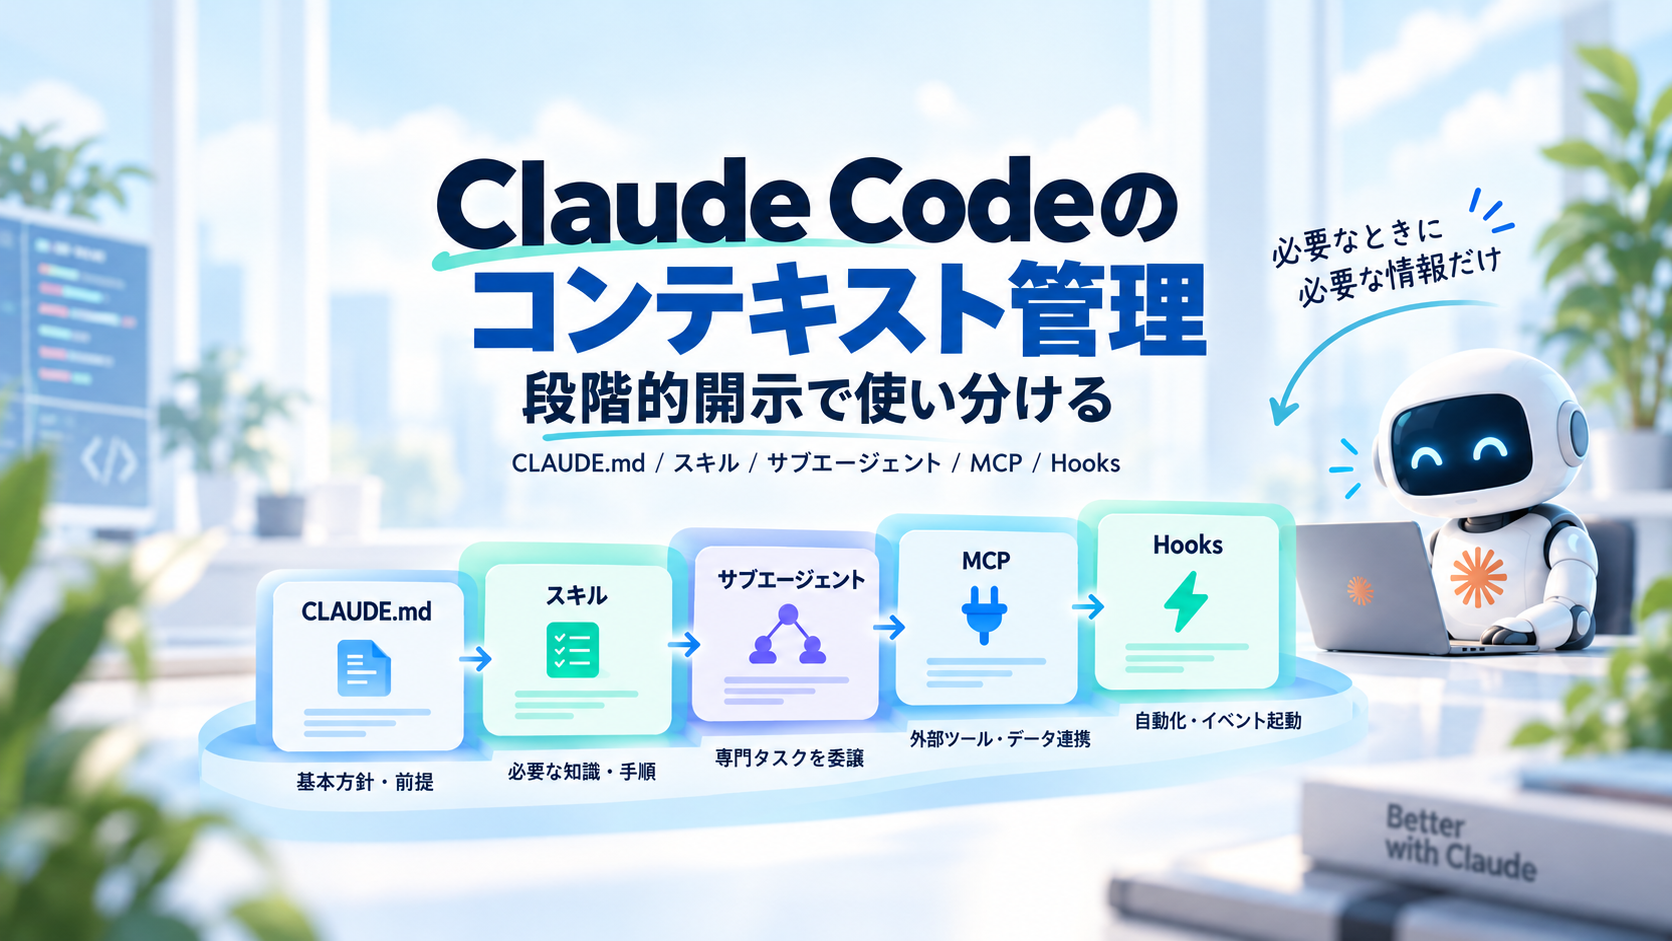
Agent Skillsには、必要な情報を最初からすべてコンテキストへ投入するのではなく、必要になった段階で参照していくという考え方があります。
いわゆる段階的開示です。
例えば、
SKILL.md
   ↓
必要になったら設計ルールを読む
   ↓
必要になったらテンプレートを読む
   ↓
必要になったらスクリプトを利用する
という流れになります。
これは設計として見ると、
インターフェースと実装の分離 + 必要な実装だけを遅延ロードする
という構造だと考えられます。
SKILL.mdにはSkill全体を理解するために必要な最小限の情報だけを置く。
具体的なルールや大量の参考資料は、必要になるまで読み込まない。
そうすることで、コンテキストを節約しながらSkillを拡張できます。
単にファイルを分割して整理しているのではなく、
「どの情報を、どのタイミングでAgentに見せるか」
という設計まで含んでいるのがAgent Skillsのおもしろいところだと思います。
依存性逆転にも近づいていく
さらに、この設計を進めていくと「依存性逆転」の考え方にも近づいてきます。
例えば、影響調査Skillが、
grepを実行する
ことに依存しているとします。
すると、そのSkillは具体的なツールに強く依存しています。
一方、
依存関係を調査する
という抽象的な処理に依存させれば、具体的な方法は差し替えられます。
             SKILL.md
                 │
          依存関係を調査する
                 │
       ┌─────────┼─────────┐
       ↓         ↓         ↓
   Windows      Java   TypeScript
       │         │         │
    grep等     AST解析   Compiler API
上位にあるSkillは、具体的な実装方法を知りません。
「依存関係を調査できること」だけを前提にしています。
これは、
上位の仕組みが具体的な実装へ直接依存しない
という考え方です。
Agent Skillsを作っているだけなのに、インターフェース、責務分離、抽象化、依存性逆転といった、これまでプログラミングで学んできた設計原則がそのまま登場してくるのは非常に興味深いです。
Agent Skillsでも「何を書くか」より「何を書かないか」が重要になる
最初にAgent Skillsを作り始めると、SKILL.mdへできるだけ詳しく指示を書きたくなります。
その方がAgentが正確に動きそうに感じるからです。
しかし、詳しく書けば書くほど、Skillは特定の用途や実装へ密結合していきます。
そこで、
- Skillそのものの責務は何か
- 何をInputとして受け取るか
- 何をOutputとして保証するか
- どのような処理の流れを持つか
- 具体的なルールはどこへ置くか
- 実装方法はどこへ置くか
を考える必要があります。
これはクラスやメソッドを設計するときとよく似ています。
Agent Skillsでも重要なのは、単にプロンプトを書くことではありません。
責務と依存関係を設計することなのだと思います。
まとめ
『プリンシプル オブ プログラミング』で学んだ「インターフェースと実装の分離」をAgent Skillsへ当てはめて考えてみました。
整理すると、私は次のように考えています。
SKILL.md
→ Skillの契約と処理フロー

references/
→ 判断に必要な知識やルール

scripts/
→ 具体的な処理方法

templates/
→ 出力形式
そしてSKILL.mdを具体的な実装から切り離すことで、
- 実装を差し替えられる
- Skillを再利用しやすくなる
- 特定の技術への依存を減らせる
- 参照情報を必要なときだけ読み込める
- コンテキストを管理しやすくなる
というメリットが生まれます。
特にAgent Skillsの段階的開示と組み合わせることで、
Skillの構造は安定させたまま、具体的な知識や実装だけを交換する
という設計が可能になります。
Agent Skillsというと「AIへの指示の書き方」というプロンプト設計の延長として捉えがちです。
しかし実際に設計してみると、これまでソフトウェア開発で学んできた、
- 抽象化
- インターフェース
- 実装の分離
- 責務分離
- 依存性逆転
といった考え方が、そのまま活用できます。
Agent Skillsも結局は「どう指示を書くか」ではなく、
変更に強く、再利用できる仕組みをどう設計するか
というソフトウェア設計の問題なのかもしれません。