はじめに
技術的負債があることに気づいたとき、「このコードは直した方がいい」と思うことがある。責務が曖昧になっている、条件分岐が増えすぎている、実態と合わない値を使っている、調査するたびにソースを読み直さなければならない。こうした状態を見ると、「時間を取って全部きれいにした方がいいのではないか」と思いたくなる。
しかし、現実の開発では、そう簡単ではない。技術的負債を返すにも時間がかかる。その時間を使えば、新しい機能を作ることもできるし、障害対応を進めることもできるし、ユーザーからの要望に対応することもできる。
だからこそ、技術的負債は、見つけたらすぐに全部返すのではなく、どの負債から返すべきかを判断すること、そしてその判断をチームで見える形にしておくことが大切なのだと思う。今回は、私が実際に保守しているシステムで見つけた負債を例にしながら、技術的負債を返済するときの優先順位と、記録の仕方について考えてみたい。
ログの数字が実態と合わない
私が保守しているシステムには、複数の処理を一通り実行し、すべて正常終了すればコミット、問題があればロールバックする、という一連の処理がある。この処理では、それぞれの工程ごとに成功件数・失敗件数をワーク変数でカウントし、最後にそのワーク変数の値をログへ出力していた。
しかし、この仕組みには問題があった。途中で処理に問題が起きてロールバックされた場合でも、ワーク変数のカウント自体は途中まで積み上がった値のまま残る。つまり、実際にはロールバックされて何も確定していないのに、ログ上は「成功件数◯件」のように出力されてしまう。ログの数字と、データベースの実態が食い違っている状態だ。
このログを信用して調査すると、間違った前提で原因を探すことになる。結局、ログの数字だけでは判断できず、毎回ソースコードを読み直して、どういう条件でどこがカウントされるのかを追いかけ直す必要があった。ログは本来、調査の手間を減らすためのものだ。ところがこのケースでは、ログが信頼できないせいで、逆に調査の手間が増えていた。
技術的負債は、すべて同じ重さではない
技術的負債という言葉でまとめてしまうと、すべての負債が同じように見えてしまう。しかし、実際にはそうではない。たとえば、ほとんど使われない古い機能のコードと、日常的に動いているバッチ処理、この2つに同じような問題があったとしても、影響は大きく異なる。
ほとんど動かない処理であれば、多少ログが不正確でも、すぐに大きな問題にはならないかもしれない。一方で、日常的に動いていて、障害が起きたときに真っ先にログを確認するような処理であれば話は別だ。私が見つけたカウント処理の不整合は、まさにこの後者に近いものだった。障害調査のたびに参照される可能性のあるログが信用できない状態は、放置しておくほど調査コストを積み上げていく。
頻繁に動く場所・調査で使われる場所を優先する
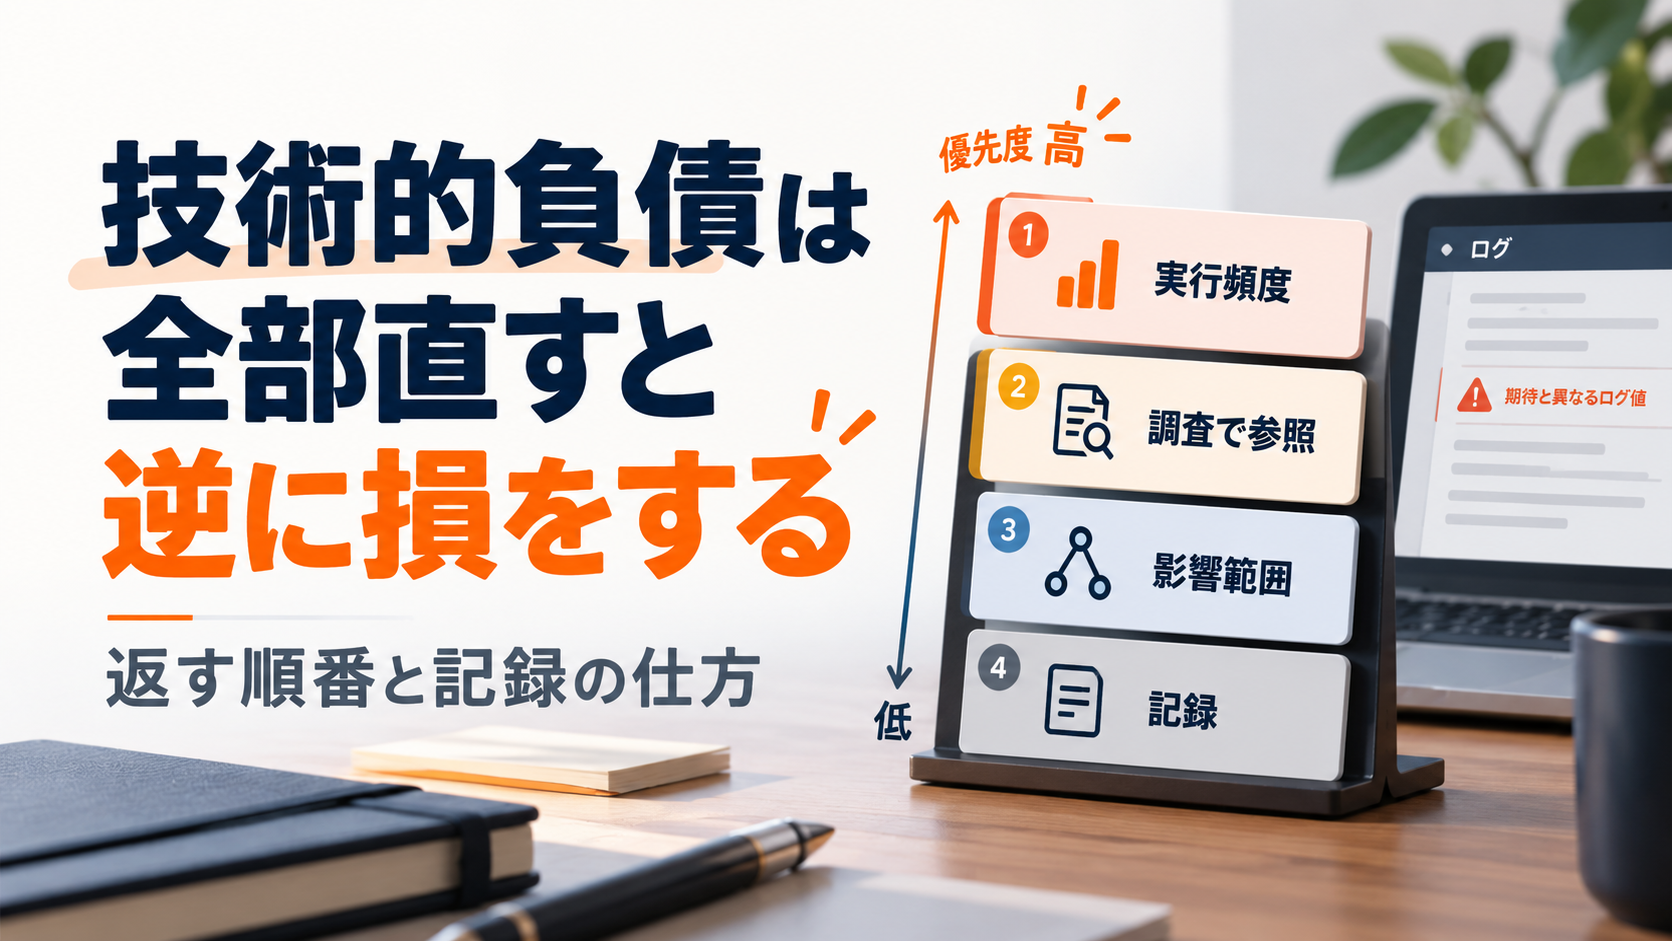
技術的負債の返済を考えるとき、最初に見たいのは、その処理をどれくらいの頻度で動かすか、そしてその出力をどれくらい調査で参照するかだ。月に何度も動くバッチ処理で、しかも障害調査のたびにログを見るのであれば、ログが不正確であることのコストは毎回発生する。理解するのに時間がかかる、正しい状態を確かめるためにソースを読み直す時間がかかる、といったコストだ。
一方で、数年間ほとんど動いていない処理であれば、同じ問題があっても、支払う利息は少ないかもしれない。だから、頻繁に動く場所、調査で頼りにされる場所ほど、負債を返す効果が大きいと考えられる。
影響範囲が大きい処理も注意する
多くの後続処理や運用フローから参照されている処理も、優先的に見たい場所だ。共通のバッチ基盤、複数の工程をまたぐ処理、他システムとの連携部分。こうした処理は、一つの不整合が多くの場所に影響する。
私が見つけたカウント処理も、複数の工程をまとめて実行するバッチの一部だった。もしこのログを信用したまま別の判断(たとえば「今回は成功したから次の処理に進めてよい」といった判断)をしてしまうと、実際のデータ状態とズレたまま運用が進んでしまう可能性がある。こうした場所は、将来的に大きなトラブルにつながる可能性があるという意味でも、注意して見ておく必要がある。
気づいたことを、まず記録する
このカウント処理の不整合について、私はまだ修正には着手できていない。ただ、気づいた時点で、チームの課題として取り上げた。
技術的負債を記録するとき、単に「このログ出力を直した方がいい」とだけ伝えても、あとから優先順位を判断しにくくなる。なぜ直したいのかがわからないからだ。今回であれば、次のような情報を残すようにした。
- どこに問題があるのか:一連の処理の成功件数・失敗件数を出力しているログ
- 何が問題なのか:ロールバックされた場合もワーク変数のカウントがそのまま出力され、実態と食い違う
- どんな影響が出ているのか:障害調査のたびに、ログを信用できず、ソースコードを読み直す必要がある
- 放置すると何が起こりそうか:ログを信用した誤った判断につながる可能性がある
「ログの数字がおかしい」という感想だけでなく、「調査のたびにソースを読み直す手間が発生している」という、実際に発生しているコストとして共有することを意識した。
まだ直していないという判断も、いったんはあり得る
技術的負債を見つけても、すぐに直せるとは限らない。今回のカウント処理の問題も、見つけてから時間が経っているが、他の優先度の高い作業があり、まだ着手できていない。
これは、「直さないと決めた」わけではなく、「今はまだ着手できていない」という状態だ。技術的負債の管理で大事なのは、すべてを即座に直すことではなく、どこに問題があるかを見える状態にしておき、着手できるタイミングが来たときにすぐ対応できるようにしておくことだと思う。バックログやチケットに残すだけで終わらせず、なぜ直したいのか、どんなコストが発生しているのかまで書いておくことで、後から優先順位を判断しやすくなる。
コードの汚さではなく「利息」で考える
技術的負債の優先順位を決めるとき、私は、どの負債が最も大きな利息を生んでいるかという視点がわかりやすいと思う。たとえば、次のような負債だ。
- 頻繁に動く処理である
- 障害調査のたびに参照される
- 多くの後続処理・運用判断に影響する
- 実態とログ・記録が食い違っている
こうした場所は、日常的に時間を奪っている。つまり、返済すれば、その後の調査時間を継続的に減らせる可能性がある。
逆に、多少古くて読みにくいコードでも、ほとんど動いていない、障害調査で参照されることもない、他の判断に影響しないという場所であれば、すぐに直さなくてもよいかもしれない。技術的負債の返済は、コードの美しさではなく、今後どれだけ時間を取り戻せるかで考えると判断しやすくなる。
定期的に見直す
技術的負債は、一度記録したら終わりではない。今は着手できていないカウント処理の問題も、今後この周辺のバッチを改修する機会があれば、そのタイミングで一緒に直せるかもしれない。逆に、その処理自体が将来的に廃止される予定であれば、無理に直す必要がなくなることもある。
定期的に、「今どんな技術的負債が残っているか」「その負債は今も問題なのか」を見直すことで、優先順位を更新できる。大げさな仕組みである必要はなく、スプリントの振り返りや、次の開発計画を立てるタイミングで確認するだけでも違うはずだ。
まとめ
技術的負債は、ゼロにすることが目的ではない。重要なのは、チームの開発速度や品質を大きく損なう負債を放置しないこと、そして気づいた負債を忘れずに見える状態にしておくことだ。
私が見つけたログとデータの不整合は、まだ直せていない。しかし、気づいた時点でチームの課題として記録したことで、「いつか直したい」が「今後どこかのタイミングで直すべき課題」として扱える状態になったと感じている。
判断軸 | 返済・記録を優先すべき状態 | 後回しにしてよい状態 |
|---|---|---|
実行頻度 | 日常的に動く処理である | ほとんど動いていない |
調査での参照 | 障害調査のたびにログ・記録を見る | 参照されることがほとんどない |
影響範囲 | 多くの後続処理・運用判断に影響する | 影響する範囲が限定的 |
記録の残し方 | 何が・なぜ・どんな影響かまで書く | 「直した方がいい」という感想だけで終わる |
技術的負債の管理とは、すべてを綺麗にすることではなく、返すべき負債を選び、それを見える形にしておくことなのだと思う。限られた時間を、どの負債にどう向き合うか。その判断まで含めて、技術的負債とうまく付き合っていきたいと思っている。
関連記事
関連リンク
Amazonで見る
プリンシプル オブ プログラミング 3年目までに身につけたい 一生役立つ101の原理原則
見る →
Amazonで見る
改訂新版 良いコード/悪いコードで学ぶ設計入門 ―保守しやすい 成長し続けるコードの書き方
見る →